n8n으로 1:1문의 중복 체크 자동화 시스템 구축
부동산 서비스의 1:1 문의 CS를 자동화한 기록. n8n 워크플로가 새 문의를 과거 문의 목록과 대조해 중복 여부를 판단하도록, 알고리즘 비교 대신 LLM 판단을 조합해 구축한 과정을 정리한다.
n8n 로고
어떤 서비스든 고객과 소통하기 위한 CS 창구가 존재합니다. 우리 회사 역시 1:1 문의 방식으로 CS를 운영하고 있는데, 가끔 대기 시간이 길어지면 동일한 내용을 반복해 등록하는 유저들이 있습니다. 이 때문에 하루에도 200건이 넘는 중복 문의글이 발생했고, CS팀에서는 이를 해결할 방법을 요청해 왔습니다.
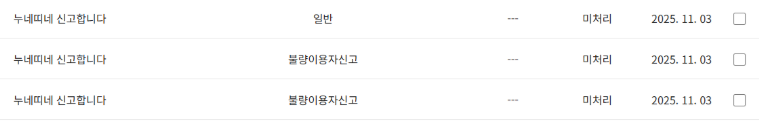
1:1 문의 리스트
처음 요청은 “중복 작성 유저를 블랙리스트로 관리하는 기능”이었지만, 이는 문제 해결책이라기보다 단순한 패널티에 가까웠습니다. 또한 블랙리스트 관리라는 새로운 업무가 추가된다는 점도 부담이었습니다. 그래서 애초에 중복 문의글을 CS 담당자의 화면에 노출시키지 않으면 어떨까? 라는 방향으로 생각을 전환하게 되었습니다.
문제 접근 방식: 알고리즘 vs. LLM
초기 아이디어는 신규 문의글이 저장되기 전에 기존 문의글과 유사도를 계산해 중복 여부를 판별하는 방식이었습니다. 하지만 팀장님과 논의하는 과정에서 “LLM을 활용해보자”는 제안이 나왔고, 자동화 플랫폼인 n8n의 LLM 기능을 이용해 중복 여부 판단을 맡기기로 결정했습니다. AI 기능을 직접 서비스 로직에 녹여본 경험은 처음이라, R&D 측면에서도 흥미로운 경험이 될 것이라고 판단했습니다. 아래는 전체 기능에 대한 초기 설계 개요입니다. 처음에는 답변까지 n8n으로 완료할 예정이였지만, 휴먼 컨펌이 필요하다는 CS팀의 의견으로 인해 수정이 되었습니다.
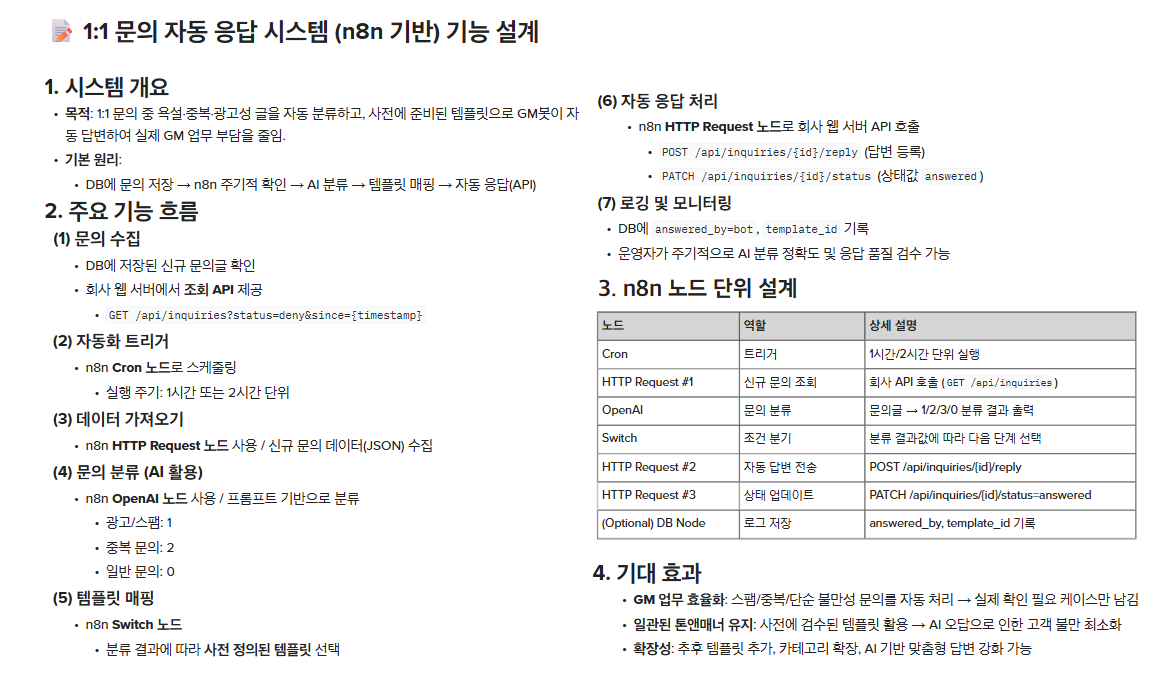
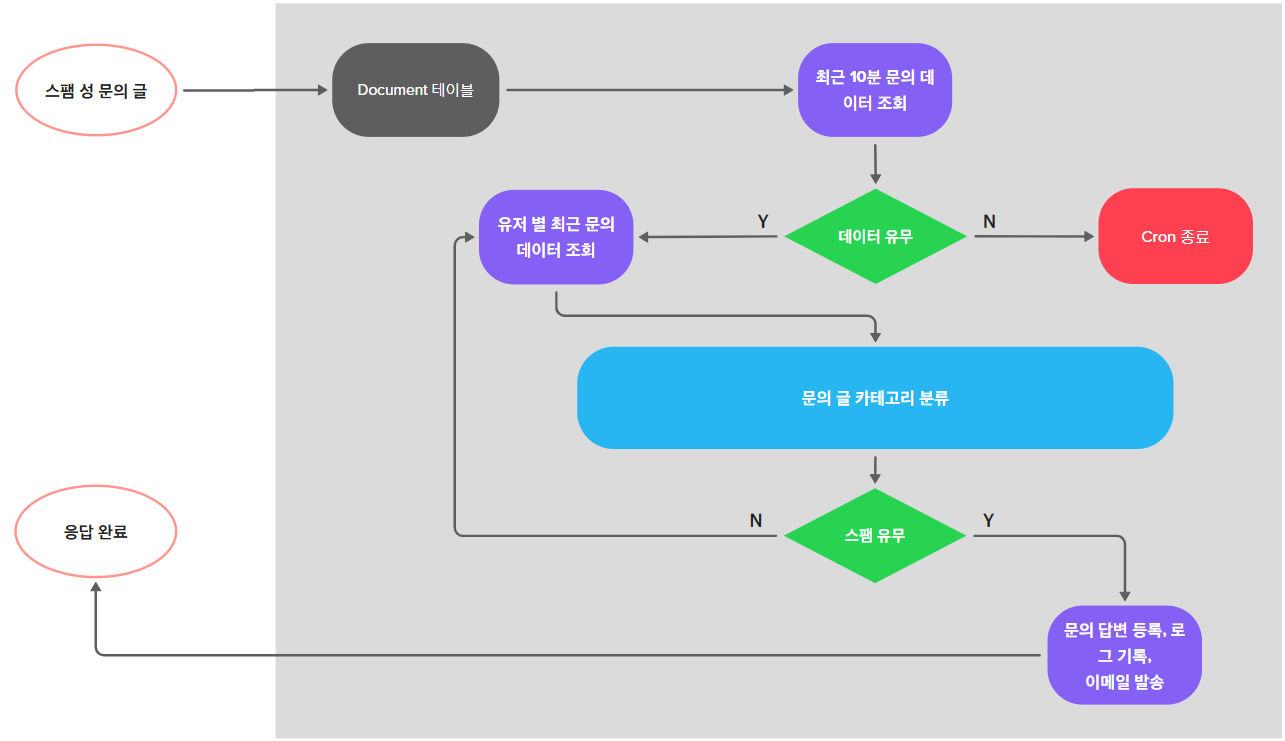
기능 설계와 워크스페이스 플로우
개발 환경 및 구축 방식
실 서버 반영은 인프라팀에서 진행할 예정이었기에, 이번 작업은 로컬 환경에서의 셀프 호스팅 기반 R&D를 목표로 설정했습니다.
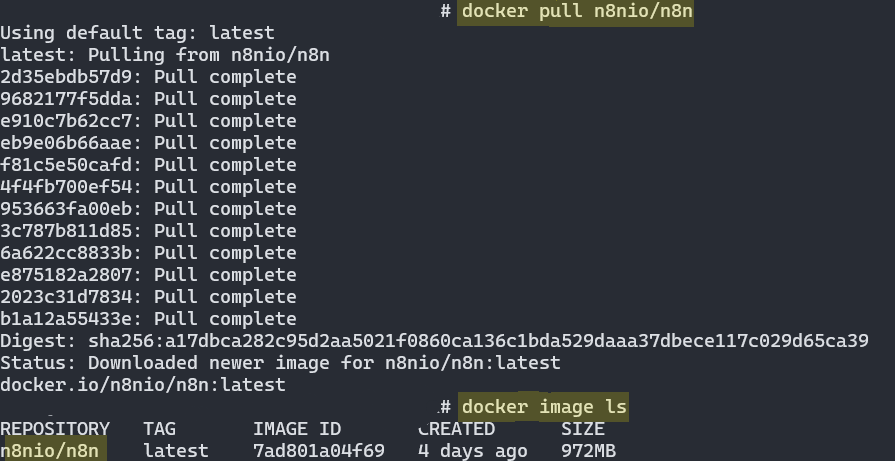
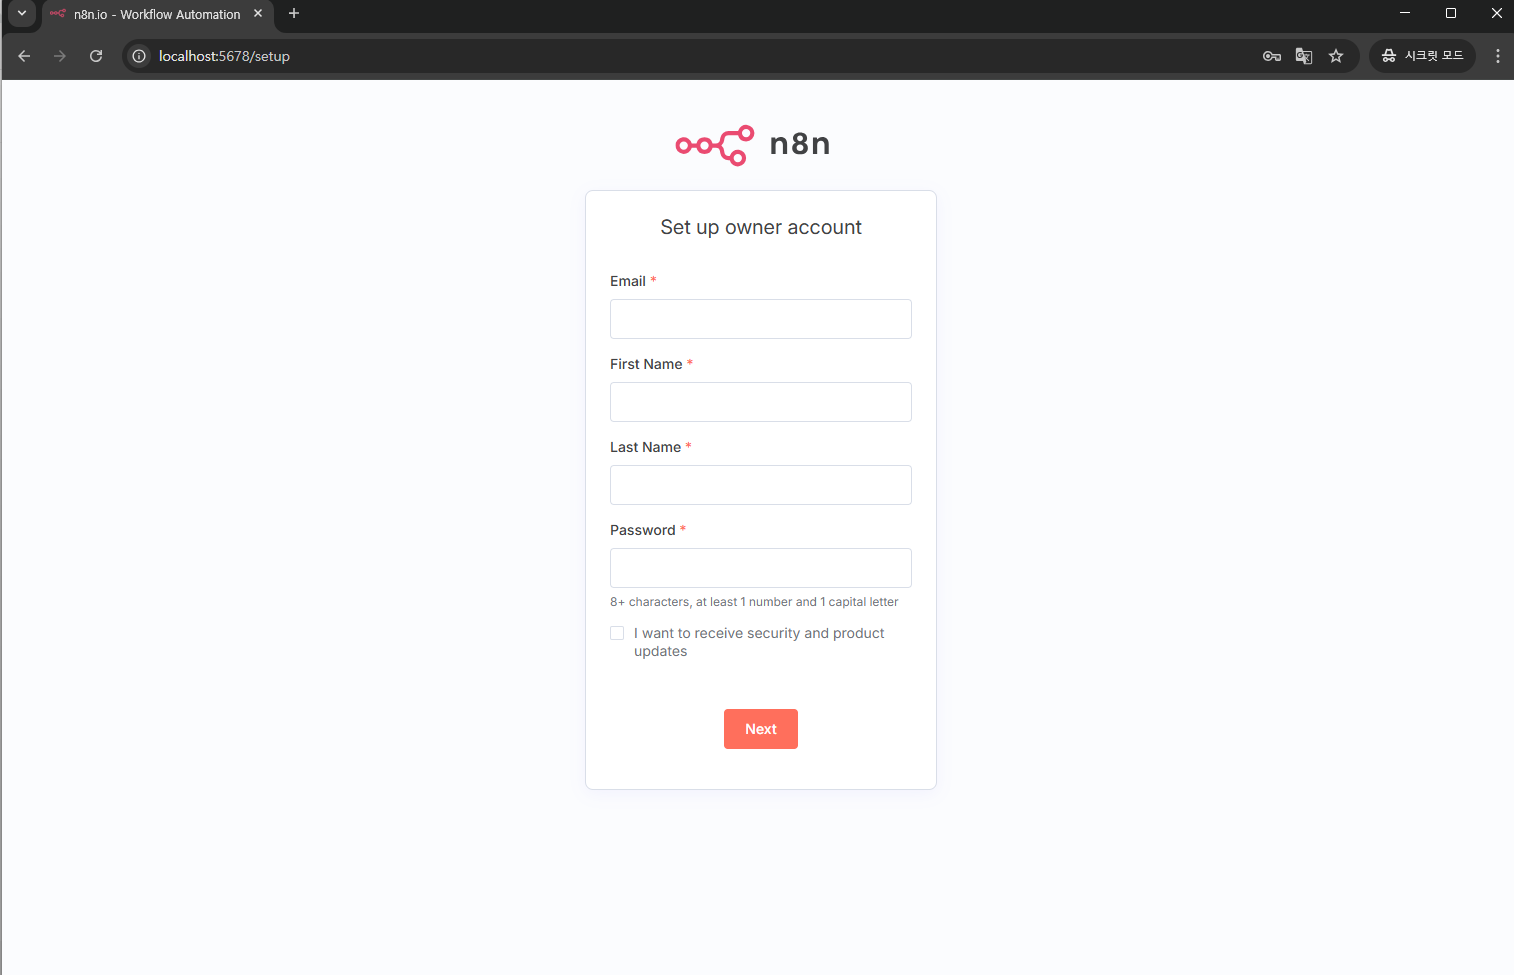
참고한 자료
- n8n 공식 문서
- 시민개발자 구씨님의 YouTube 튜토리얼
- (참고용) 위키독스 가이드북
사용 스택
- Docker CLI
- WSL
- Cloudflare (Open API 연동용 도메인 필요 시)
Docker만으로도 로컬 실행은 충분하지만, LLM API를 안정적으로 테스트하기 위해 도메인 설정이 필요했고, 이를 위해 Cloudflare를 함께 사용했습니다.
워크플로우 설계
전체 플로우는 복잡하지 않으며, n8n의 주요 노드들을 활용해 비교적 간단하게 구축할 수 있었습니다.
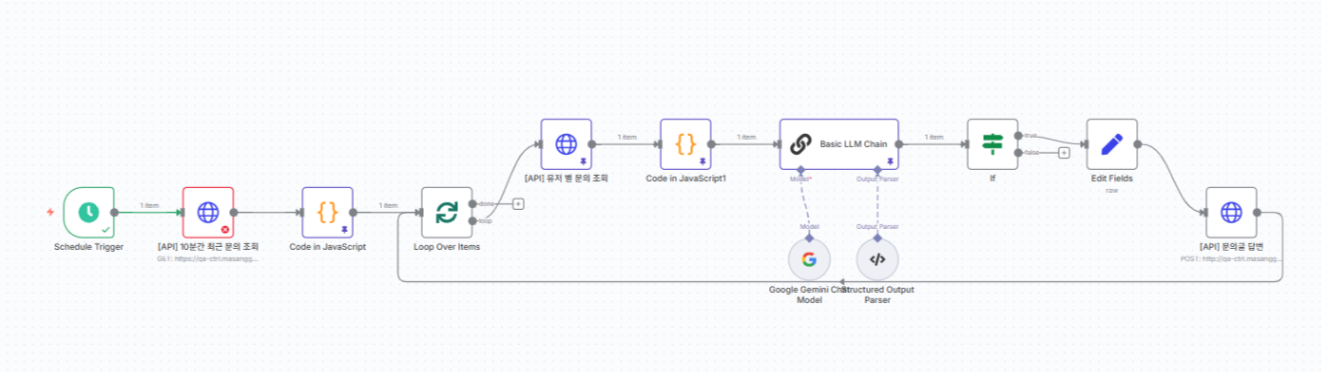
전체 워크플로우
1. Trigger 노드 (Scheduler)
가장 먼저, 워크플로우 실행 주기를 설정했습니다. 10분 간격으로 자동 실행되며, 해당 시간 동안 신규로 생성된 문의글들을 조회하는 구조입니다. 트리거 노드는 다양한 방식으로 설정할 수 있으며, 버튼·웹훅·앱 이벤트·채팅·폼 입력 등 다수의 옵션을 제공합니다. 이 중 스케줄 기반으로 워크플로우를 구동했습니다.
2. 최근 문의글 조회 API 호출
10분 이내에 등록된 문의글을 가져오는 API를 호출합니다. 응답값을 받은 뒤 Code 노드(Javascript)를 이용해 데이터를 후속 노드에서 사용하기 좋은 구조로 변환합니다.
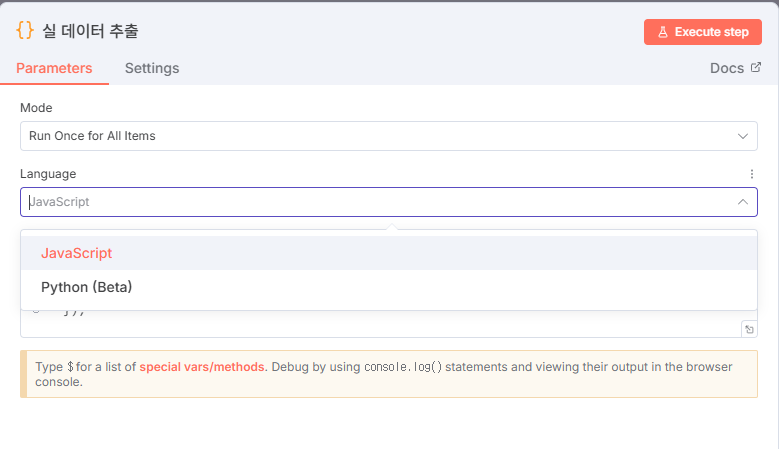
code node
개발자에게는 Code 노드가 확실히 유연하고 편리했습니다. (Python도 지원하지만 이번에는 JavaScript만으로 충분했습니다.)
return items[0].json.data.map(item => {
  return { json: item };
});
3. Loop Over Items 노드
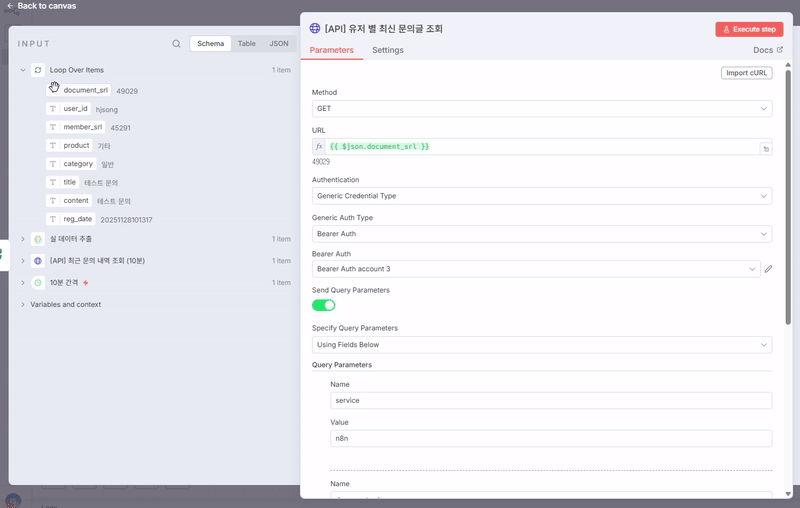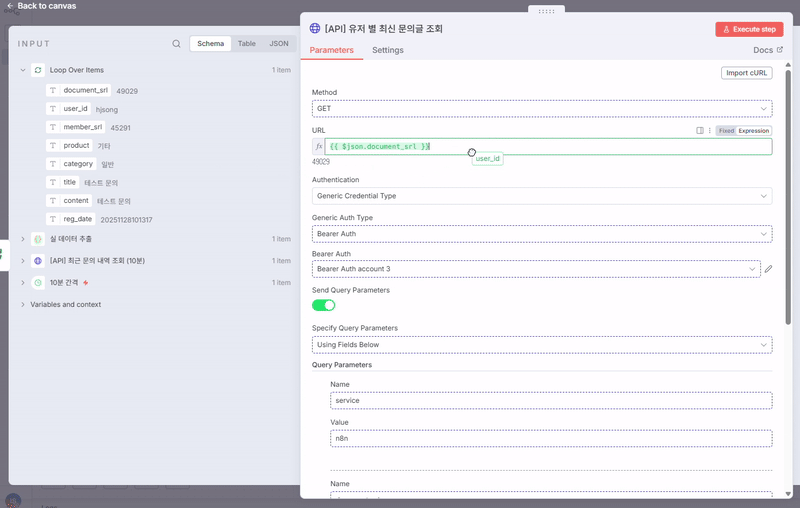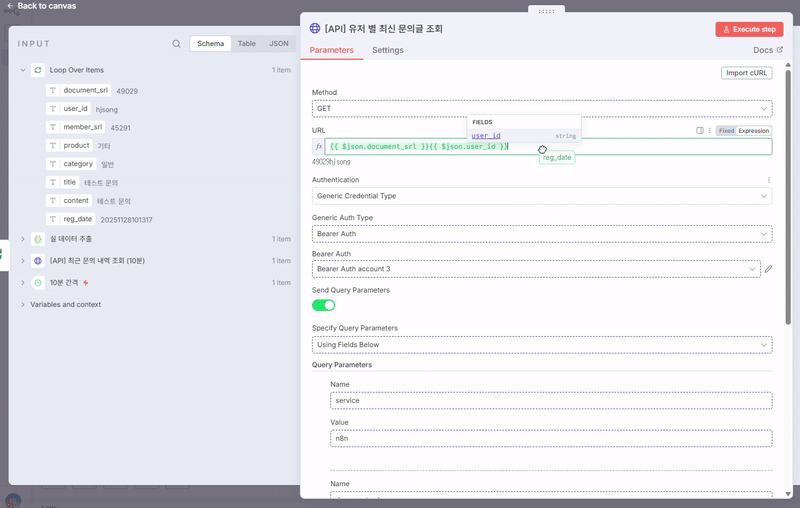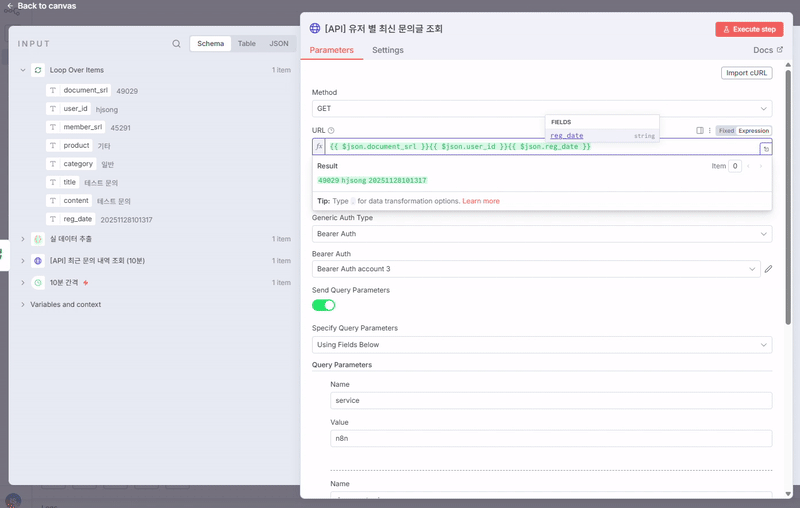
각 문의글을 하나씩 처리하기 위해 Loop 노드를 사용했습니다. 이 과정에서 문의글 작성자의 이전 문의글 리스트(미완료 5건 + 완료 3건)를 불러오는 API를 호출합니다. 노드 간 데이터 전달은 drag & drop 형태라 직관적으로 사용할 수 있습니다.
4. LLM Chain 노드 – 중복 판별 핵심 로직
이제 LLM에게 중복 여부 판단을 맡기는 단계입니다. 프롬프트는 AI와 함께 아래 기준을 중심으로 총 3회에 걸쳐 조정했습니다.
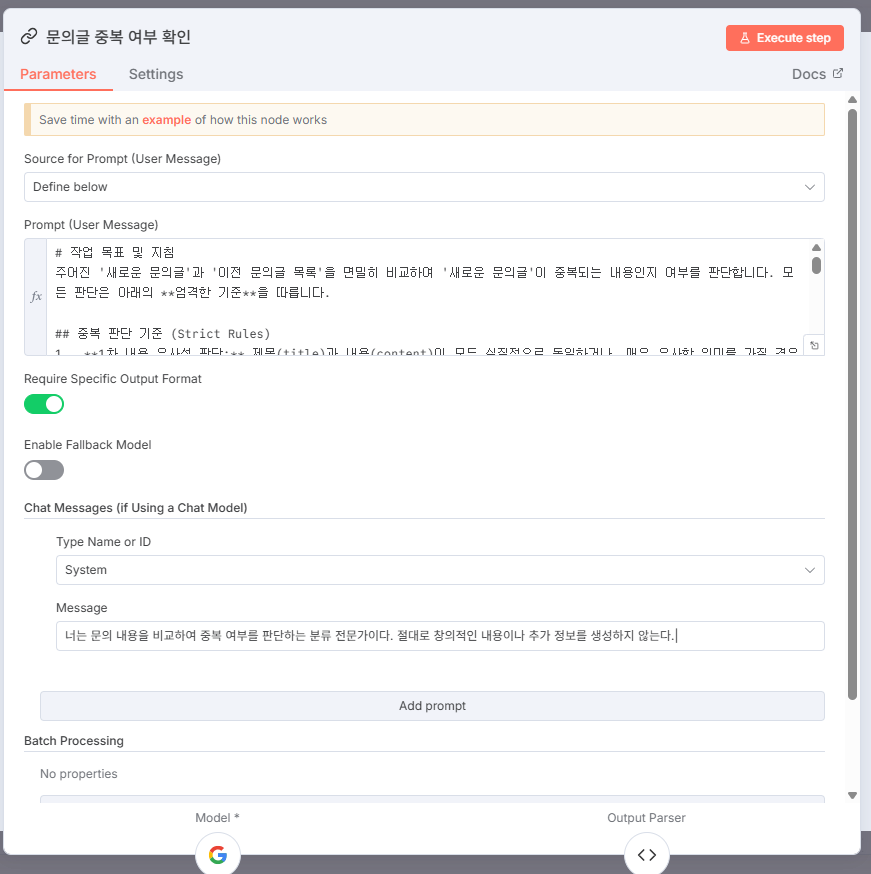
LLM Chain
중복 판별 기준 (Strict Rules)
## 작업 목표 및 지침
주어진 '새로운 문의글'과 '이전 문의글 목록'을 면밀히 비교하여 '새로운 문의글'이 중복되는 내용인지 여부를 판단합니다. 모든 판단은 아래의 **엄격한 기준**을 따릅니다.

### 중복 판단 기준 (Strict Rules)
1.  **1차 내용 유사성 판단:** 제목(title)과 내용(content)이 모두 실질적으로 동일하거나, 매우 유사한 의미를 가질 경우에만 **1차적으로** 중복으로 판단합니다.
2.  **Product 분류 일치 조건 (Critical):** 1차 중복으로 판단되었더라도, **'새로운 문의글'의 `product` 값과 '이전 문의글'의 `product` 값이 다르면**, 해당 건은 **최종적으로 중복이 아닌 것(`duplication: false`)**으로 간주하고 `reason`에는 `null`을 출력합니다.
3.  **대명사 사용 예외:** '새로운 문의글'의 내용에 '그것', '이것', '저희', '담당자' 등 맥락 파악이 어려운 **대명사가 포함**되어 있고, 그 대명사를 대신할 구체적인 내용이 '이전 문의글'에 없는 경우에는, 내용이 동일하더라도 **절대 중복으로 판단하지 않습니다.**
4.  **시간 제약 조건:** Product 일치 및 대명사 예외 조건을 통과하여 최종 중복이 유력하더라도, '이전 문의글'의 **`reg_date`**와 '새로운 문의글'의 **`reg_date`**를 비교하여, 두 날짜 간의 **차이가 3일(72시간) 이상**일 경우, 해당 건은 **최종적으로 중복이 아닌 것(`duplication: false`)**으로 간주하고 `reason`에는 `null`을 출력합니다.
5.  오직 하나의 가장 관련성이 높은 중복 문서만 선택하여 그 `document_srl`을 출력해야 합니다.
6.  위의 모든 조건에 해당하여 중복이 아닌 경우(2, 3, 4번 포함)에는 `reason`에 **null**을 출력해야 합니다.

---

## 입력 데이터
**주의: `reg_date`는 YYYYMMDDHHmmss (예: 20251126121634) 형식입니다.**

### 1. 새로운 문의글 (New Inquiry)
- title: {{ $('Loop Over Items').item.json.title }}
- content: {{ $('Loop Over Items').item.json.content }}
- **product: {{ $('Loop Over Items').item.json.product }}**
- reg_date: {{ $('Loop Over Items').item.json.reg_date }}

### 2. 이전 문의글 목록 (Past Inquiries List)
**각 항목은 `document_srl`, `title`, `content`, `product`, 그리고 `reg_date` 키를 포함합니다.**
{{ JSON.stringify($json.data) }}
- 제목·내용의 실질적 유사성
- product 분류 값 일치 여부
- 대명사 사용 예외 처리
- 작성 시간 차이(72시간 초과 시 중복 X)
- 가장 관련성 높은 문서 단 1건만 선택
- 중복이 아니면 reason은 반드시 null
이 기준을 만족하도록 LLM에게 비교 작업을 맡깁니다.
Output Parser 설정
{
  "type": "object",
  "duplication": "boolean",
  "reason": "integer"
}
5. If 노드 및 Edit Fields 노드
LLM이 duplication = true로 판단한 경우, 후속 API에 전달할 JSON payload를 생성합니다. Edit Fields 노드를 활용하여 필요한 필드를 구성하고, 마지막으로 HTTP Request 노드로 중복 기록 API를 호출하면 워크플로우가 마무리됩니다.
기대 효과
이 워크플로우 도입 후, CS 담당자가 문의글을 검토하기 전 단계에서 1차 중복 필터링이 자동으로 수행됩니다.
이를 통해 다음과 같은 효과를 기대할 수 있습니다.
- 반복 문의로 인한 CS 인력의 불필요한 소모 감소
- 실제 문의에 집중할 수 있는 환경 구축
- 사용자 경험 개선 (기존 문의의 처리 우선순위 유지)
- 운영팀 업무 자동화 기반 마련